3件の記事

pd.read_csv() で大きなCSVを読み込むとメモリを大量に使ってしまう問題を、dtype指定・category型・usecols・chunksizeの4つの方法で実際に測定しながら解決します。
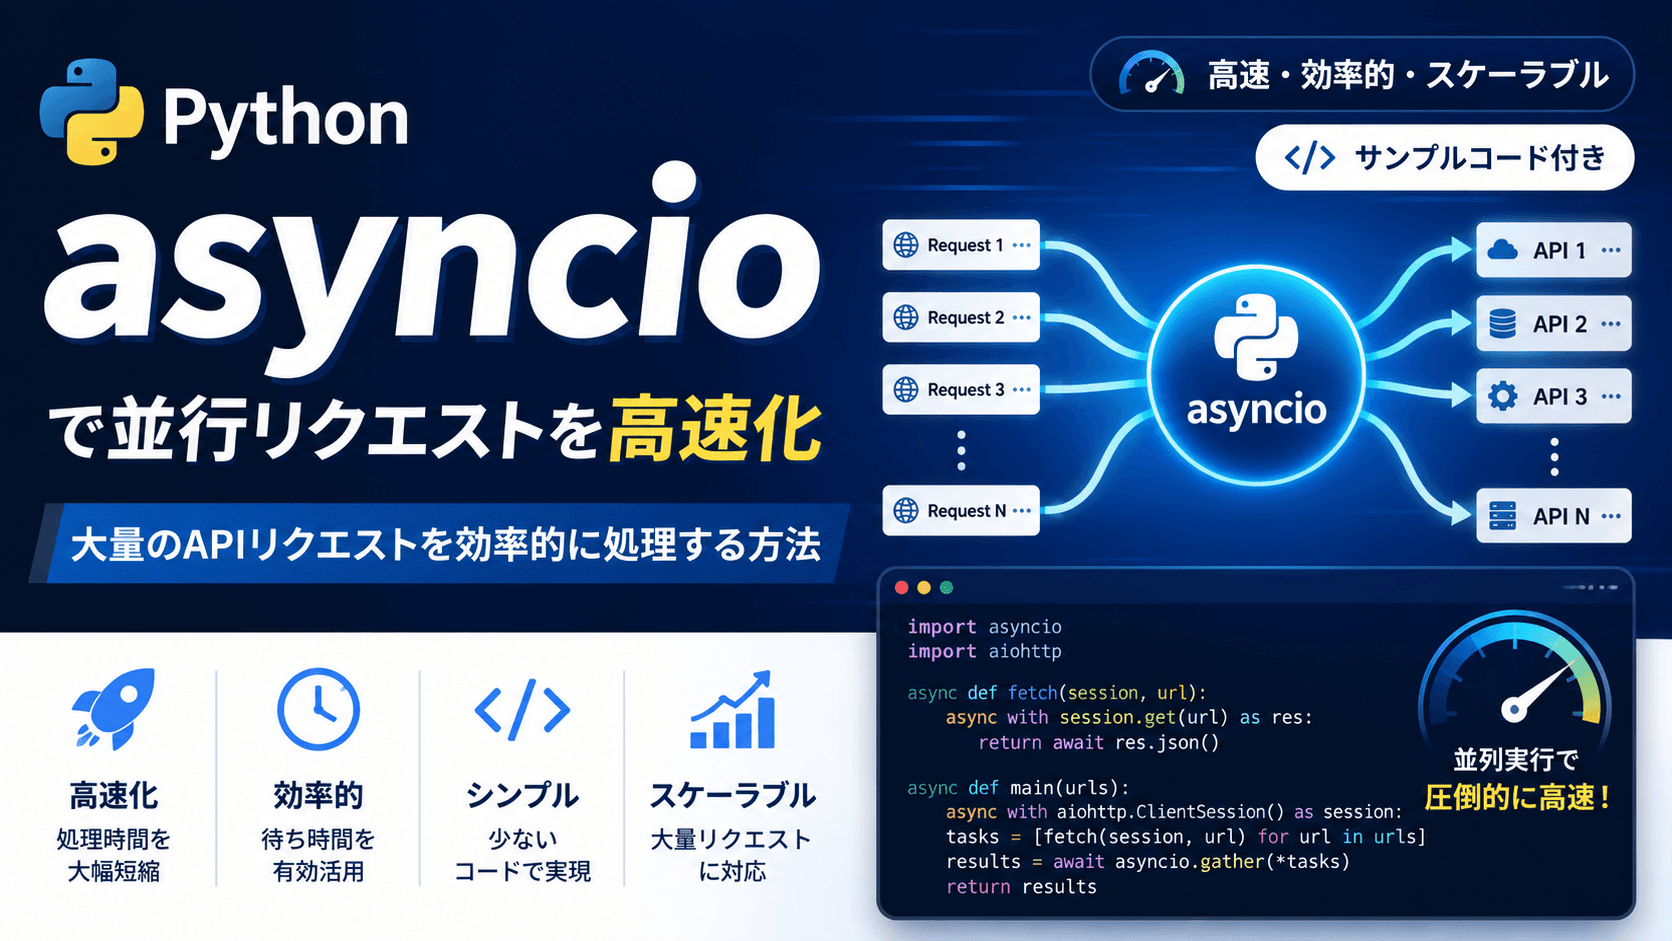
複数のAPIを逐次処理と非同期処理(asyncio)でそれぞれ実行し、所要時間を実測して比較しました。なぜ並行化で速くなるのか、どんな処理には効かないのかを、実コードと計測結果をもとに解説します。

ファイルのリネームやExcelからのデータ抽出といった繰り返し作業をPythonで自動化した記録です。ライブラリの豊富さと、数ヶ月後に読み返しても意図が分かる読みやすさという、Pythonを選んだ2つの理由を実コードとともに紹介します。
